
El archivo robots.txt se ha convertido en una de las piezas más relevantes del SEO moderno. Ya no solo decide si Google puede indexar tus páginas, ahora también permite indicar a OpenAI, Anthropic, Perplexity, Google u otros proveedores de IA si pueden utilizar tu contenido para entrenar modelos, mostrarlo en buscadores conversacionales o consultarlo cuando un usuario se lo pide.
La clave está en no tratar todos los bots de IA como un único bloque. Hay rastreadores que buscan contenidos para entrenar modelos, otros que construyen índices para respuestas con enlaces y fuentes, y agentes que acceden a una URL concreta porque una persona se lo ha solicitado.
¿Qué es robots.txt y por qué importa ahora con la IA?
robots.txt es un archivo de texto que se publica en la raíz de un dominio, normalmente en https://tudominio.com/robots.txt. Su función es comunicar instrucciones de rastreo a los bots: qué zonas pueden acceder, cuáles deben evitar y con qué frecuencia no deben saturar el servidor.
Ejemplo de robots.txt -> https://eloyquiros.com/robots.txt
Durante años, su uso principal ha sido evitar que Google, Bing u otros buscadores rastrearan páginas de administración, resultados internos, carritos, filtros con parámetros o contenidos duplicados. Con la irrupción de la IA generativa, el archivo ha adquirido una segunda función: actuar como mecanismo de control sobre el uso de contenidos públicos por parte de sistemas de inteligencia artificial.
Sin embargo, conviene ser preciso: robots.txt no es una licencia de uso ni una herramienta legal. No impide que alguien copie un texto manualmente, ni sustituye los términos y condiciones, una política de copyright o los acuerdos con proveedores. Lo que hace es establecer una señal técnica pública que los rastreadores que respetan este estándar deben atender.
Por otro lado, tampoco bloquea la indexación en Google. Si bloqueas Googlebot, impedirás que el buscador acceda a tus páginas; si bloqueas Google-Extended, estás enviando una señal relacionada con el uso de tus contenidos en determinados productos de IA de Google, sin afectar al rastreo y la indexación tradicional en la Búsqueda.
Esta distinción es fundamental para cualquier estrategia SEO. Una web puede querer seguir siendo visible en Google y, al mismo tiempo, limitar que sus artículos alimenten el entrenamiento de modelos. O puede preferir abrir la puerta a los buscadores de IA para ganar citas, enlaces y tráfico referido, pero cerrarla a los rastreadores de entrenamiento.
Tipos de bots de IA: entrenamiento, búsqueda y agentes de usuario
No todos los bots relacionados con inteligencia artificial hacen lo mismo. Antes de copiar reglas, conviene entender para qué quiere acceder cada uno a tu web.
Bots de entrenamiento. Estos rastreadores recopilan contenidos públicos que pueden incorporarse a los datos utilizados para entrenar o mejorar modelos de lenguaje. Suelen ser los más controvertidos, porque el contenido puede contribuir a generar respuestas futuras sin que la web reciba necesariamente una visita o una atribución directa.
Entre los más conocidos se encuentran GPTBot de OpenAI, ClaudeBot de Anthropic y CCBot de Common Crawl.
Bots de búsqueda con IA. Su objetivo es localizar y organizar páginas para mostrarlas como fuentes en respuestas conversacionales. Si permites su acceso, tu contenido puede aparecer citado, con enlace y, en ocasiones, con un resumen generado a partir de la página.
OAI-SearchBot alimenta la búsqueda de ChatGPT, Claude-SearchBot contribuye a los resultados de búsqueda de Claude y PerplexityBot permite que una web pueda aparecer y citarse en Perplexity.
Agentes activados por el usuario. Estos bots acceden a una URL cuando una persona lo pide explícitamente dentro de un chat o asistente. Por ejemplo, si un usuario pide a ChatGPT, Claude o Perplexity que lea una página concreta, el sistema puede recuperar ese contenido en tiempo real.
Es el caso de ChatGPT-User, Claude-User y Perplexity-User. Su función es recuperar información en tiempo real para responder a una petición específica, no recorrer masivamente la web
Tokens de control. Google-Extended y Applebot-Extended merecen una mención aparte. Son señales que Google y Apple leen desde robots.txt para decidir si el contenido ya rastreado por sus sistemas puede emplearse en determinadas funciones de IA, como el entrenamiento o el uso en Gemini. Bloquear Google-Extended no saca tu web de Google Search ni afecta directamente a su posicionamiento orgánico.
| Tipo de bot | Ejemplos | Qué hace | Consecuencia de bloquearlo |
|---|---|---|---|
| Entrenamiento | GPTBot, ClaudeBot, CCBot | Recopila contenido para datasets de IA | El contenido queda fuera de futuros entrenamientos |
| Búsqueda con IA | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Indexa páginas para respuestas con fuentes | Menor presencia y citas en esos buscadores |
| Agente de usuario | ChatGPT-User, Claude-User, Perplexity-User | Consulta una URL a petición de un usuario | El asistente puede no poder leer esa página |
| Token de control | Google-Extended, Applebot-Extended | Gestiona el uso de contenido en IA | No bloquea el rastreo tradicional de Google o Apple |
Listado de user agents de IA más importantes
Esta es una lista práctica de los identificadores que conviene conocer al configurar robots.txt. No es exhaustiva, porque el ecosistema cambia con rapidez, pero cubre los bots más habituales en auditorías y registros de servidor.
- GPTBot: rastreador de OpenAI asociado a la recopilación de contenido para entrenamiento de modelos.
- OAI-SearchBot: rastreador de OpenAI para su índice de búsqueda.
- ChatGPT-User: agente que accede a páginas cuando un usuario de ChatGPT lo solicita.
- ClaudeBot: rastreador de Anthropic vinculado a la recopilación de contenido para entrenamiento.
- Claude-SearchBot: rastreador de Anthropic para búsqueda e indexación.
- Claude-User: agente que consulta páginas a petición de un usuario de Claude.
- PerplexityBot: rastreador de Perplexity para su buscador con IA y la selección de fuentes.
- Perplexity-User: agente que recupera una página cuando un usuario de Perplexity lo pide.
- Google-Extended: token de control relacionado con el uso de contenidos en productos de IA de Google, como Gemini; no es un crawler independiente.
- Applebot-Extended: token de control de Apple para determinados usos de IA; tampoco realiza peticiones como un rastreador convencional.
- CCBot: rastreador de Common Crawl, que construye corpus web utilizados por múltiples proyectos e investigaciones de IA.
- Bytespider: rastreador asociado a ByteDance, frecuente en análisis de tráfico y políticas de bloqueo de IA.
Un matiz técnico importante: en robots.txt, las reglas se agrupan por user agent. Si escribes varias líneas User-agent seguidas y después una directiva Disallow, esa regla se aplica a todos los bots incluidos en el grupo. Si separas los grupos, cada bot puede recibir instrucciones distintas.
¿Bloquear o permitir a los bots de IA?
No existe una respuesta universal. La decisión correcta depende de tu modelo de negocio, del valor que atribuyes a la visibilidad en respuestas generativas y de tu tolerancia al uso de tus contenidos como material de entrenamiento.
Ventajas de permitir (visibilidad y citas en respuestas de IA)
Permitir el rastreo de los buscadores de IA puede abrir una nueva vía de descubrimiento. Cuando un asistente cita tu web como fuente, obtienes una referencia visible, un posible clic y una señal de autoridad temática ante usuarios que ya no comienzan todas sus búsquedas en Google.
Además, aparecer en respuestas de IA puede reforzar la percepción de experiencia y especialización. Para un blog técnico, un medio especializado o una consultora, ser citado como fuente puede tener un valor reputacional superior al de una simple visita.
También existe un argumento de continuidad: los buscadores con IA no van a desaparecer. Permitir a bots como OAI-SearchBot, Claude-SearchBot o PerplexityBot permite participar en ese canal mientras se conserva la posibilidad de bloquear los rastreadores de entrenamiento.
Ventajas de bloquear (propiedad del contenido, carga del servidor)
Bloquear tiene sentido cuando el contenido es el activo principal del negocio. Una editorial, una empresa con documentación exclusiva, un portal de datos o un sitio con informes de pago pueden preferir limitar la reproducción y el aprovechamiento de su material por terceros.
También puede ser una decisión operativa. Los rastreadores consumen recursos, especialmente en webs con muchas páginas, imágenes pesadas o hosting compartido. Si detectas picos de tráfico artificial, errores de rendimiento o un consumo elevado de ancho de banda, limitar ciertos bots puede aliviar la carga.
Por último, bloquear los bots de entrenamiento permite mantener un control más claro sobre cómo evoluciona tu contenido dentro de los modelos. No evita todos los usos posibles, pero reduce la contribución directa de tus páginas a futuros datasets de proveedores que respetan robots.txt.
Qué recomendar según el tipo de negocio (pyme, ecommerce, medio, blog)
La estrategia más sensata suele ser segmentada, no radical.
- Pyme de servicios: permitir bots de búsqueda y agentes, pero valorar el bloqueo de entrenamiento. La visibilidad en respuestas puede generar consultas, mientras que el contenido corporativo rara vez es tan sensible como para necesitar un bloqueo total.
- Ecommerce: permitir búsqueda y agentes si se quiere aparecer en recomendaciones y comparativas; bloquear entrenamiento si se prioriza la protección de fichas, descripciones y datos comerciales. Conviene mantener fuera del rastreo carrito, checkout, cuenta de cliente y URLs de facetas.
- Medio digital: decidir según el modelo de ingresos. Un medio abierto puede beneficiarse de citas y enlaces; un medio con muro de pago o contenidos premium debería proteger esas secciones y evaluar cuidadosamente el acceso al resto.
- Blog personal o de autoridad: permitir búsqueda suele ser interesante para ganar presencia y enlaces. Bloquear entrenamiento puede ser una opción coherente si el autor quiere conservar mayor control sobre la reutilización de sus textos.
- Web con documentación técnica o datos propios: bloquear entrenamiento y revisar qué se expone públicamente. Aquí conviene combinar robots.txt con autenticación, cabeceras y una política de uso clara.
Ejemplos de robots.txt listos para copiar y pegar
Antes de aplicar cualquier ejemplo, haz una copia del archivo actual. Un error de sintaxis, una regla demasiado amplia o un Disallow: / mal ubicado puede impedir el rastreo de páginas que sí quieres que Google indexe.
Bloquear solo el entrenamiento y permitir la búsqueda
Esta configuración busca un equilibrio habitual: permites que los buscadores con IA citen tus páginas, pero dificultas que los rastreadores de entrenamiento las utilicen.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Esta opción es especialmente útil para blogs, webs corporativas y pymes que quieren mantener presencia en buscadores conversacionales sin ceder su contenido al entrenamiento masivo.
Bloquear todos los bots de IA
Si tu prioridad es proteger el contenido y reducir el tráfico automatizado, puedes bloquear los principales user agents y tokens relacionados con IA.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: CCBot
User-agent: Bytespider
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Ten en cuenta que esta configuración reduce las posibilidades de aparecer como fuente en ChatGPT Search, Claude Search o Perplexity. No afecta al posicionamiento tradicional en Google, siempre que Googlebot siga permitido.
Permitir todo y proteger rutas privadas
Si tu estrategia es máxima visibilidad, puedes permitir los bots de IA y reservar el bloqueo para áreas que no deben ser rastreadas.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /carrito/
Disallow: /finalizar-compra/
Disallow: /mi-cuenta/
Disallow: /checkout/
Disallow: /*?add-to-cart=
Disallow: /*?orderby=
En un ecommerce, estas rutas evitan desperdiciar rastreo en páginas sin valor SEO y reducen el riesgo de que los bots accedan a procesos transaccionales. En WordPress, la excepción de admin-ajax.php es habitual porque algunos temas y plugins la necesitan para funcionar correctamente.
Cómo implementarlo
La implementación depende de tu plataforma, pero el principio es el mismo: editar el archivo robots.txt que se sirve desde la raíz del dominio.
En WordPress, si utilizas Yoast SEO, Rank Math o SEOPress, puedes editar robots.txt desde el panel del plugin. Es la opción más cómoda porque el archivo se actualiza sin acceder al servidor. Si tu WordPress genera un robots.txt virtual, es posible que necesites crear un archivo físico en la raíz para que las reglas personalizadas tengan prioridad.
En PrestaShop, normalmente se accede por FTP, SFTP o el gestor de archivos del hosting. Localiza el archivo en la carpeta raíz, descarga una copia de seguridad, edítalo y súbelo de nuevo. Si no existe, puedes crearlo como archivo de texto plano con el nombre exacto robots.txt. También existe la posibilidad de instalar un pequeño módulo para editar el archivo de forma sencilla desde el panel de control de Presta.
En un servidor propio, VPS o hosting con acceso a archivos, el proceso es igual: abre el administrador de archivos, ve a la raíz pública del dominio, normalmente public_html, edita el archivo y guarda los cambios.
Al escribir las reglas, respeta esta estructura:
User-agent: NombreDelBot
Disallow: /ruta-a-bloquear/
Y recuerda que una línea en blanco separa grupos de reglas. No mezcles instrucciones de distintos user agents dentro del mismo bloque si quieres políticas diferentes para cada uno.
Después de guardar, comprueba que el archivo responde con un código 200 y que el contenido visible es el esperado. Evita editarlo desde un editor de texto que añada formato, comillas tipográficas o caracteres invisibles.
Cómo comprobar que funciona
La comprobación tiene dos niveles: verificar que robots.txt se sirve correctamente y confirmar que los bots interpretan las reglas.
Primero, abre https://tudominio.com/robots.txt en el navegador. Deberías ver el texto exacto que has guardado, sin errores de codificación ni contenido HTML añadido. Si aparece una página de error, un redireccionamiento o el archivo anterior, revisa la caché del CDN, el hosting o la configuración del plugin SEO.
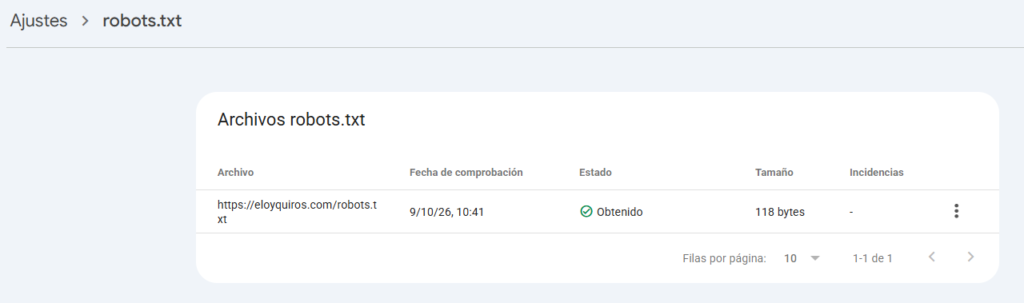
Después, utiliza el informe de robots.txt de Google Search Console. Permite comprobar si Google detecta el archivo, si hay errores de sintaxis y qué URLs considera bloqueadas. Es especialmente útil tras una migración, un cambio de hosting o una modificación importante de reglas.
Para validar URLs concretas, usa la Inspección de URLs de Search Console. Introduce una dirección y comprueba si Google puede rastrearla. Esto ayuda a detectar el error más peligroso: haber bloqueado por accidente una categoría, una ficha de producto o una página clave.
En cuanto a los bots de IA, revisa los registros del servidor o las herramientas de seguridad y CDN. Busca los user agents que has bloqueado y observa si siguen apareciendo peticiones. Si un bot continúa accediendo pese a la regla, puede estar ignorando robots.txt, utilizando otro identificador o tratándose de tráfico que requiere una regla adicional en el firewall.
Finalmente, monitoriza durante algunas semanas el tráfico desde buscadores con IA, las citas de marca y las peticiones de rastreo. La decisión sobre IA no es permanente: conviene revisarla cuando cambien tus objetivos de visibilidad, tu modelo de negocio o las políticas de los principales proveedores.